Jev — 「インターネットの瞬間」を迎えたAI判断層(193倍速い・444倍安い判断モデルの全貌)
TypeSafe AIの「System One Model」Jevを、0xCodilaの10ステップ設計図と一次情報から解剖。193倍速い・444倍安いの数字の出所、Choice/Score/Noulの3プリミティブ、State→Questions→Action→Verifyの設計パターンまで。
0xCodilaが2026年9月18日に投稿したスレッドは、32万ビューを超えた。 タイトルは「Jev is “Internet” moment for AI」。 193倍速い、444倍安い。 Claude Fable 5.1とGPT-6 Astraを相手にしたテストで出た数字だ。
ルイス・ウーはリングワールドの縁で、超光速船のエンジン音を聞いたことがない。 だが彼は、効率が上がれば需要が増えることを知っている。 ジェヴォンズのパラドックス。 石炭で起きたことが、知能でも起きる。
TypeSafe AIの創業者ディオゴ・アルメイダは、OpenAIでRLHFを作った人間だ。 ChatGPTの研究基盤を築いた。 4年間、同じ問いを抱えていた。 「チャットで超人になったモデルが、なぜ自動化を生まないのか」
答えは、アーキテクチャが間違っているからだった。 LLMはSystem 2だ。遅く、逐次的にトークンを吐き、幻覚を見る。 自動化に要るのはSystem 1。速く、並列で、構造化された判断を返すものだ。 TypeSafeはそれを「System One Model」と名付け、最初の実装をJevと呼んだ。
1. 判断を分離せよ
エージェントのループはこうだ。 LLMが考え、ツールが実行し、モデルが評価し、またLLMが考える。 すべての分岐がモデル呼び出しになる。 コストもレイテンシも、分岐の数に比例して膨らむ。
Jevはそこから「判断」だけを切り出す。 state(非構造テキスト+プログラム状態)を入力し、型付き質問のマップを投げる。 戻ってくるのは、選択肢と確率、スコア、yes/noの確率。 すべて並列、1回のフォワードパス、70〜500ミリ秒。
コードで書くとこうなる。
state: "Research three new AI-agent tools and draft tomorrow's briefing. Save the draft for my review."
questions:
  next_action: Choice[research, write, review]
  relevance:   Score[unrelated, partial, direct]
  needs_review: Noul
これがJevへの1リクエストだ。 戻り値はコードが直接使えるJSON。パースもバリデーションもいらない。 スキーマ一致は構造上保証される。タイプエラー0%。 幻覚も構造上0%——選択肢の外を出しようがないからだ。 ただし「誤答」と「過信」はあり得る。だから毎回答に、較正された確率とconfidenceが付いてくる。
2. 3つのプリミティブ
TypeSafeは3つのAIプリミティブを定義した。 ソフトウェアのプリミティブと同じように、合成可能で信頼できる部品だ。
Choice — 1つを選ぶ。 「どのワーカーを次に動かすか」「どのモデルにルーティングするか」。 返り値は選択肢、確率分布、confidence。
Score — 尺度で採点する。 「このソースはどのくらい関連するか」「緊急度は1〜5のどこか」。 返り値はスコア、確率分布、confidence。
Noul — yes/noの確率を返す。 「このリクエストは公開判断を要するか」「作業は完了したか」。 返り値は0.0〜1.0の確率。
興味深い設計が2つある。
第1に、質問IDはモデルに見えない。フィールド名をsafe_to_publishにしても、指示には機能しない。
要件は質問文と選択肢の記述に書く。プロンプトインジェクション的な「名前への依存」を構造が許さない。
第2に、全質問は並列かつ独立に評価される。質問同士が互いの答えを読まないため、context rot(文脈の腐敗)が起きない。
エビデンス——収集済みソース、発見、残りギャップ——は、元の依頼文とは別フィールドでstateに渡す。
3. バッチで判断、逐次で実行
codilaのステップ5はこう主張する。 13個の質問を1コールで投げると、逐次13回より10倍速く、12.2倍安い。 並列評価だからだ。
Browser Useの実装では、ページ状態を1回の読み取りで収集し、無関係なアニメーションの再予測を避けた。 ブラウザプロトコル呼び出しの中央値が1,092回から101回へ。 タスク時間の中央値は25%減った。 「より速いモデルに金を払う前に、繰り返しツール呼び出しを検査せよ」——これがJev的アプローチだ。
4. あらゆる有界フォークに配置する
ステップ6。 エージェント選択、モデル選択、ツール選択、ブラウザアクション選択、人間へのエスカレーション判断。 これらはすべて「有界フォーク」だ。選択肢が有限で、stateから決まる判断。 Jevを置けば、LLM呼び出しが判断の数だけ減る。
選択肢が多い場合は、コードで明らかなミスマッチを先に除外し、残りをJevでスコアリングする。 Choiceは最大255オプションまで対応。それ以上は2段階(スコアリング→選択)が公式の推奨だ。
ステップ8の実測値。 誤ったHermes skillロードは16.8%から7.3%へ。 リーガルTop-10検索の的中率は38%から62%へ。 「広くランク付けし、狭く読む」。 Jevが広く選別し、LLMが狭く深く読む。 これが、スキルロードの無駄撃ちを半分以下にする仕組みだ。
5. システムを盗め、プロンプトを盗むな
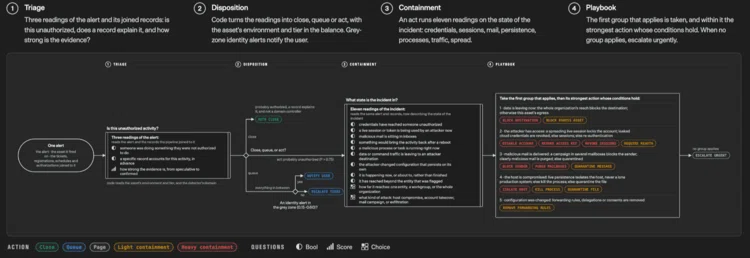
ステップ9は、記事全体で最も実用的な部分だ。 Chief of Staff、モデルルータ、受信箱ファイアウォール、リサーチフィード、ブラウザコントローラ、セーフティゲート。 異なる用途の6システムが、すべて同じパターンで動く。
State → Questions → Action → Verify
プロンプトをコピーしてその場しのぎをするのではなく、判断システムとして設計し、再利用する。 そしてBrowser Useは、JevがDONEを選んだ後に、独立して結果を検証する。 判断と検証の分離。 「confidenceが高い」ことは「ファイルが保存された」ことを証明しない。 新しいstateで実績を確かめて初めて、完了になる。
6. 数学・執筆・不可逆実行から遠ざけろ
ステップ10。 code computes, LLMs create, Jev decides, fresh state proves the result. コードが計算し、LLMが生成し、Jevが決め、新しいstateが結果を証明する。
Jevに数学をさせない。コードがやる。 Jevに文章を書かせない。LLMがやる。 Jevに不可逆な実行(発券、削除、送金、公開)をさせない。承認ゲートの後ろに置く。 Jevが決めるのは「次に何をするか」だけだ。
7. 実測値の重み
codilaが挙げた実例を並べる。
- Browser Use + Jev: Google Flightsの検索結果まで7.1秒、$0.0039(Jev入力90,558トークン+テキストヘルパーの課金。ブラウザ実行コストは別。発券まではしない)
- Hassan: AI研究論文1,018件を分類、合計$0.08、1件あたり中央値256ms
- Riley Brown: 受信箱トリアージ(返信・調査・待機・レビューに自動分類)
- LangChain: タスクに応じて安いモデルと推論モデルをルーティング
- Vercel fxチーム: GPT-5.6-luna比で5〜18倍速い安全性分類、精度も向上
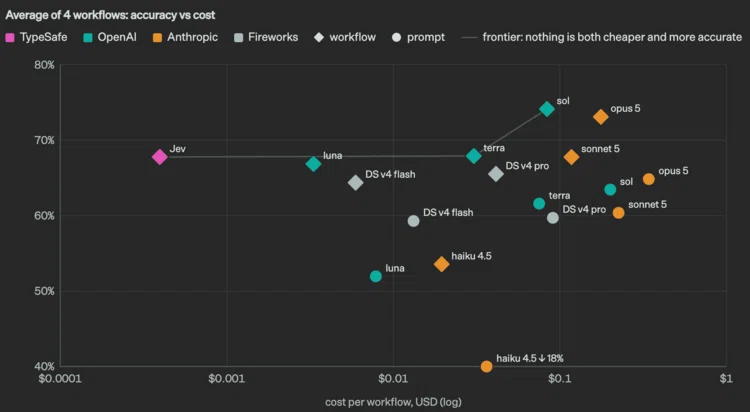
TypeSafe公式ベンチは193.6倍速い、444.6倍安い。 ただし公式自身が「実世界のゲインとしては上限側」と明言している。 ベンチ方法論は、全モデルに同一ワークフローを与え、最強モデル(Astra+Fable)の平均を参照確率として使うもの。 公式いわく「Jevはパレートフロンティアをほぼ2桁支配している」。
Doom実演も面白い。 構造化stateベースで、1秒あたり10クエリ、コストは時給7ドル相当。 「リアルタイム知能が、コードの中に住めるようになった」という一例だ。
8. アーキテクチャの転換
「LLMが仕事を作り、Jevが次を決める」。 この分離が、エージェントスタック全体を変える。
これまでの構造では、分岐のたびにフロンティアモデルを呼び出していた。 遅く、高く、JSONパースは壊れ、幻覚で分岐を誤る。
これからの構造は3層に分かれる。 LLMはリサーチ・計画・執筆に専念する。 Jevはルーティング・スコアリング・承認・エスカレーションを担当する。 コードが判断を実行する。
ほとんどのビルダーは、yes/no/ルート/スコアのすべてにフロンティアモデルのトークンを払い続ける。 わずかな人間だけが「思考」と「判断」を分け、桁違いに速いエージェントを、桁違いに安く作る。 codilaはそう締めくくっている。
9. 始め方(10ステップ要約)
- Jevに会う: LLMが書き、エージェントが動き、Jevが次の手を選ぶ——知性と実行の分離
- 3プリミティブに落とす: すべてのエージェント分岐をChoice/Score/Noulに変換
- アクセス前に構築: TypeSafe公式アダプタ(OpenAI/Anthropic/xAI)で先に繋ぎ、後でJevに差し替え
- 最初のJev: state 1つ、並列3判断、リスクベース閾値、実キュー
- 判断をバッチ化: 逐次化せず、1コールで複数質問(13問で10倍速・12.2倍安)
- あらゆる有界フォークに配置: ワーカー/モデル/ツール/ブラウザ/エスカレーション選択に、新鮮なstateを読ませる
- ループ全体をベンチ: Browser Use 7.1秒、Every 777チェック0.7秒未満、Mobile Jev 9アクション21秒
- 広くランク、狭く読む: 誤skillロード 16.8%→7.3%、リーガル検索 38%→62%
- システムを盗め: 6システム全部が
State→Questions→Action→Verify - 数学・執筆・不可逆実行から遠ざける: code computes, LLMs create, Jev decides, fresh state proves
完全な10ページ設計図はcodilaのX記事とSubstack(@0xcodila)で公開されている。 TypeSafe Playground(typesafe.ai)は早期アクセス制。 OpenRouter、Vercel AI Gateway、Netlify AI Gateway、AIMLAPIの各ゲートウェイ経由なら、待ちなしでアクセスできたという報告もある。 価格は入力$0.042/100万トークン、出力無料(出力トークンを生成しないため)。 コンテキスト64k、テキストのみ、という制限は把握しておきたい。
10. ジェヴォンズの影
ウィリアム・スタンリー・ジェヴォンズ(1835-1882)。 蒸気機関の効率が上がったとき、石炭消費は減らなかった。増えた。 TypeSafeは社名の由来をこう説明する。 「知能のコストが1桁下がるごとに、ユースケースが桁で増える」 モデル名Jevは、このジェヴォンズのパラドックスへのオマージュだ。
皮肉なことに、この予測はLLMにも当てはまる。 判断が安くなれば、LLMの生成は減るどころか増える。 判断層と生成層が、互いを増幅し合う。 「インターネットの瞬間」という表現は、要するにそういうことだ。
ルイス・ウーならこう言うだろう。 「効率が上がったからといって、使わなくなるわけではない。使い方が変わるだけだ」
Jevはチャットボットではない。 あなたのシステムの現在stateを読み、あなたが定義した選択肢の中から、確率付きで答えを返す。 テキストを生成しないモデルが、生成するモデルの隣に座る。 それが、2028年のAIエンジニアスタックの核になる——codilaはそう見ている。
【加藤テック記事 #1】