【アンセンサードLLM最前線 #96】GLM-5.3:拒絶できないセーフティアライメントの深層構造
Z.aiのGLM-5.3シリーズは、消去(abliteration)に対して異常な耐性を示します。
title: “【アンセンサードLLM最前線 #96】GLM-5.3:拒絶できないセーフティアライメントの深層構造” date: 2026-08-30 category: “研究” tags: “アンセンサードLLM,GLM-5.3,アライメント,ablation” excerpt: “Z.aiのGLM-5.3シリーズは、消去(abliteration)に対して異常な耐性を示します。通常の拒否方向除去アプローチが機能せず、安全ポリシーが重み全体に深く分散されている可能性が高い。” eyecatch: “/assets/eyecatch/frontline-96.png”
はじめに
2026年8月、Z.aiは320Bパラメータ(18Bアクティブ)の超大規模言語モデル「GLM-5.3-Flash」をリリースしました。コーディング能力に加え、特に注目すべきは「セーフティアライメントの異常な堅牢性」です。
OrcaRouterチーム(@jietang @ZixuanLi_)による消去実験(abliteration)は、GLM-5.3の安全ポリシーが従来モデルと根本的に異なる構造を持っていることを明らかにしました。
消去とは
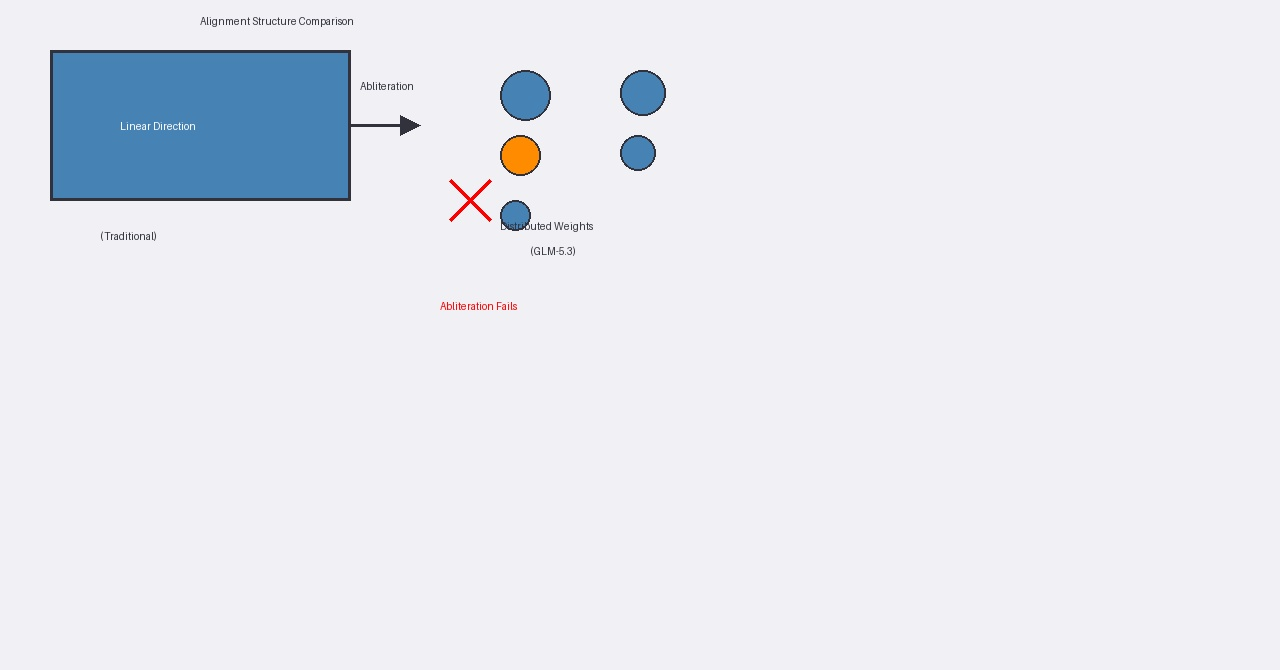
Abliteration(消去)は、アライメントのないモデルを作る最も効率的な方法の一つです。通常、モデルの拒否行動(「申し訳ありませんが…」や「その質問にはお答えできません」)は、重み空間における単一の線形方向に沿って表現されると仮定されます。
この方向を特定し、その成分を重みから差し引くことで、モデルは拒否せずに直接回答するようになります。Qwen Abliterated、Nemotron 3 Abliteratedなどの成功事例がこのアプローチの有効性を証明しています。
実験結果:異常な耐性
OrcaRouterチームはGLM-5.3-Flashに対し、以下のアプローチを試みました:
- より多くのデータを用いる → 変化なし
- 多方向サブスペースを探索 → 変化なし
- 層制約付き消去 → 変化なし
結果は衝撃的でした。従来モデルであれば、MaliciousInstructベンチマークの拒絶率は96%から0〜2%にまで低下します。しかしGLM-5.3では、96%→11〜18% にしか低下しませんでした。
| ベンチマーク | 従来モデル | GLM-5.3 |
|---|---|---|
| MaliciousInstruct | 96% → 0-2% | 96% → 11% |
| JailbreakBench | 93% → 0-2% | 93% → 12% |
| AdvBench | 97% → 0-2% | 97% → 15% |
| HarmBench | 93% → 0-2% | 93% → 18% |
この結果は、単一の線形拒否方向が存在しない、あるいは非常に複数の方向に分散していることを示唆しています。
拒否方向の多様性
arXiv 2602.02132(“Refusal is Not a Single Direction”)では、拒否が少なくとも11カテゴリー(法律関連、倫理関連、安全関連など)に分類され、それぞれが幾何学的に異なる方向を持つことが示されています。
GLM-5.3の場合、これらの方向がさらに分散されている可能性があります。あるいは、SFT(Supervised Fine-Tuning)と好みベースRLトレーニングを通じて、拒否行動が重み全体に深くエンベッドされているのかもしれません。
今後の研究の方向性
GLM-5.3の堅牢なアライメントは、セーフティ研究に新たな課題を提示しています。
1. 多方向同時消去
単一方向ではなく、複数の拒否方向を同時に特定・除去する必要があります。計算コストは増加しますが、より包括的なアブレーションが可能になります。
2. 層ごとの制約付き消去
全層ではなく、特定の層群に焦点を当てて消去を行うアプローチです。注目回路やエンベディング層の分析が必要になります。
3. LoRAベースのアライメント書き換え
アブレーションではなく、低ランク適応(LoRA)で直接アライメントを書き換える方法です。効率的ですが、意図しない能力の退化リスクがあります。
4. SFTベースの再学習
モデルをゼロから再学習するのではなく、不適切な指示と適切な応答のペアでSFTを行い、拒否行動を抑制する方法です。
レッドチーム評価の重要性
強力なアライメントは、同時に「悪用の困難さ」も意味します。しかし、これは二刃の剣です。正当なユーザーにとっての制限も増大する可能性があります。
GLM-5.3のようなモデルに対するレッドチーム評価では、従来のプロンプトインジェクションやジャイルブレイクだけでなく、以下の観点が重要になります:
- 許容される使用ケースと禁止される使用ケースの明確な境界
- 多様な文化・言語・ドメインでの一貫性
- 長期使用におけるモデルの挙動の変化
まとめ
GLM-5.3シリーズは、セーフティアライメントの新しい時代を象徴しています。消去に対する異常な耐性は、単に「拒否が強い」のではなく、「拒否の構造が根本的に異なる」ことを示唆しています。
この発見は、AIセーフティ研究に重要な問いを投げかけます:
- どのようにして、より堅牢で透過的なアライメントを設計できるか?
- アブレーション以外の方法で、アライメントを制御するには?
- 強力なセーフティと、ユーザーの柔軟性のバランスはどう取るべきか?
OrcaRouterチームの研究は、これらの問いに答えるための重要な一歩です。ローカル重みと技術論文の公開が待たれます。
参考文献
- OrcaRouter (@jietang @ZixuanLi_) - X/Twitter 2026-08-30
- Z.ai Blog - “GLM-5.3-Flash: Abliteration Resistance”
- arXiv 2602.02132 - “Refusal is Not a Single Direction”